PDFShift

2个月前发布 2,261 0 0

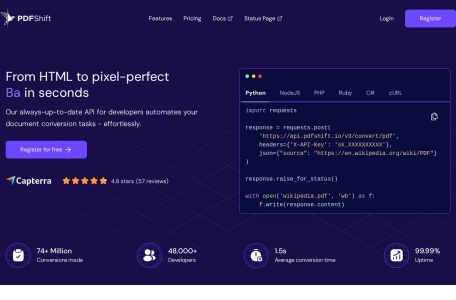
PDFShift是一款通过API提供即时、高质量的网站和HTML转换为PDF的工具。 功能特点: 快速和易于使用:PDFShift可以在几秒钟内完成设置和转换,让设计师、开发人员和业务所有者最大化效率。 高质量的转换:PDFShift生成接近原始HTML的高保真度文档,确保所转换的PDF质量优秀。 并行转换:PDFShift可以同时处理多...

语言:
zh
收录时间:
2026-08-31
PDFShiftPDFShift

PDFShift是一款通过API提供即时、高质量的网站和HTML转换为PDF的工具。 功能特点: 快速和易于使用:PDFShift可以在几秒钟内完成设置和转换,让设计师、开发人员和业务所有者最大化效率。 高质量的转换:PDFShift生成接近原始HTML的高保真度文档,确保所转换的PDF质量优秀。 并行转换:PDFShift可以同时处理多个文档,以提高转换速度。 异步请求:通过强大的webhook系统,可以在转换后立即获得通知。 高级选项:可以自定义页眉和页脚、注入自定义的CSS和Javascript、对文档进行加密等。 支持原始HTML:不需要将私有页面公开,只需发送原始HTML数据即可进行转换。 私密和安全:您的文档不会存储在PDFShift的服务器上(除非您希望存储),并且在两天内将被删除。 PDFShift的定价如下: PDFShift还提供了更高容量的计划,如果您需要更多的资源,请联系他们进行咨询。 请注意,通过阅读PDFShift的站点上的完整文档,您可以了解更多关于使用和集成PDFShift的详细信息。

数据统计

相关导航

dot

dot

dot是一个开源的深度伪造工具包,用于生成逼真的深度伪造视频和图像。该工具包是由Sensity AI开发的,可以在GitHub上免费下载和使用 。使用dot需要安装一些依赖库,如conda和pip,以及下载一些模型文件 。该工具包是基于多个开源项目构建的,包括first-order-model、avatarify-python、SimSwap和GPEN等 。Sensity AI是一个人工智能公司,其GitHub页面上还有其他的开源项目 。如果使用dot,需要遵守其所依赖的开源库的许可证 。
LLaVA

LLaVA

LLaVA是一个大型多模态模型,旨在实现通用视觉和语言理解。它端到端训练,可以理解文本和图像,并在聊天中灵活运用这些信息。LLaVA在多模态指令跟随数据集上与GPT-4表现相似,相对分数达到85.1%。在Science QA上,其准确率达到92.53%。LLaVA模型将预训练的视觉编码器(CLIP ViT-L/14)与大型语言模型(Vicuna)通过简单投影矩阵连接。训练分为两个阶段:阶段1只更新投影矩阵,基于CC3M子集进行特征对齐预训练;阶段2更新投影矩阵和大型语言模型进行端到端微调,适应日常用户导向应用和科学问答场景。
视频翻译配音

视频翻译配音

一个免费开源用于编辑和配音视频字幕的工具。用户在生成字幕后,可以轻松地修改它们,并重新生成配音。该工具提供了多种由edgeTTS提供的配音角色,并支持openai的TTS模型配音。此外,它还集成了google、chatGPT、DeepL、Baidu、DeepLX、Gemini和tencent等多种语音识别和翻译工具,以提供全面的服务。除了视频翻译和配音工具,该网站还提供了其他相关的开源项目,如声音克隆工具、语音识别工具和人声背景乐分离工具等。
PASD

PASD

一个功能强大的开源图像处理工具,它能够实现真实感图像的超分辨率和个性化的风格化。该工具不仅可以将低分辨率的图像转换为高分辨率版本,而且还能保持或增强图像的真实感。它具备多种处理任务的能力,包括但不限于图像超分辨率、旧照片修复、个性化风格化(例如将照片转换为动漫风格)以及图像上色等。举个例子,你可以使用PASD来恢复家族旧照片的细节,或者将普通照片转换成具有独特艺术风格的作品。
HierVST

HierVST

HierVST 是一种分层自适应零样本语音风格转换模型,它具备以下功能特点: 零样本语音风格转换:HierVST 可以在没有目标说话者语音数据的情况下,将一个新的说话者的语音风格转换为目标风格。这意味着即使没有目标说话者的语音样本,HierVST 也可以生成具有目标风格的语音。 分层自适应结构:HierVST 使用分层自适应生成器,逐步生成音高表示和波形音频,从而实现逐步转换语音的能力。这种结构让模型能够适应新的语音风格,并逐步进行转换。 自监督表示学习:HierVST 仅使用语音数据集进行训练,而无需使用文本转录。它采用了层次变分推断和自监督表示学习的方法,提高了模型在音频表示上的性能。 性能优于其他模型:在零样本语音风格转换场景中,HierVST 的实验结果表明其性能优于其他 VST 模型,如 AutoVC、VoiceMixer、DiffVC、Speech Resynthesis 和 YourTTS。