办公小浣熊 办公小浣熊聚焦面向人工智能创作与应用的在线工具,适合创作者、开发者和需要提升效率的用户使用。,官网域名为office.xiaohuanxiong.com。适合需要相关工具与资源的个人用户、创作者或团队使用,可从官网了解最新功能、使用方式和服务条款。
Vidu AI Vidu AI):极速打造精彩视频的创意工坊 在视频创作领域,Vidu AI 以其强大的功能和独特的优势脱颖而出,成为众多创作者和企业实现创意视觉化的得力伙伴。Vidu AI 是一个专注于提供高效、高质量 AI 视频生成服务的平台,其网站(https://www.vidu.studio/)犹如一
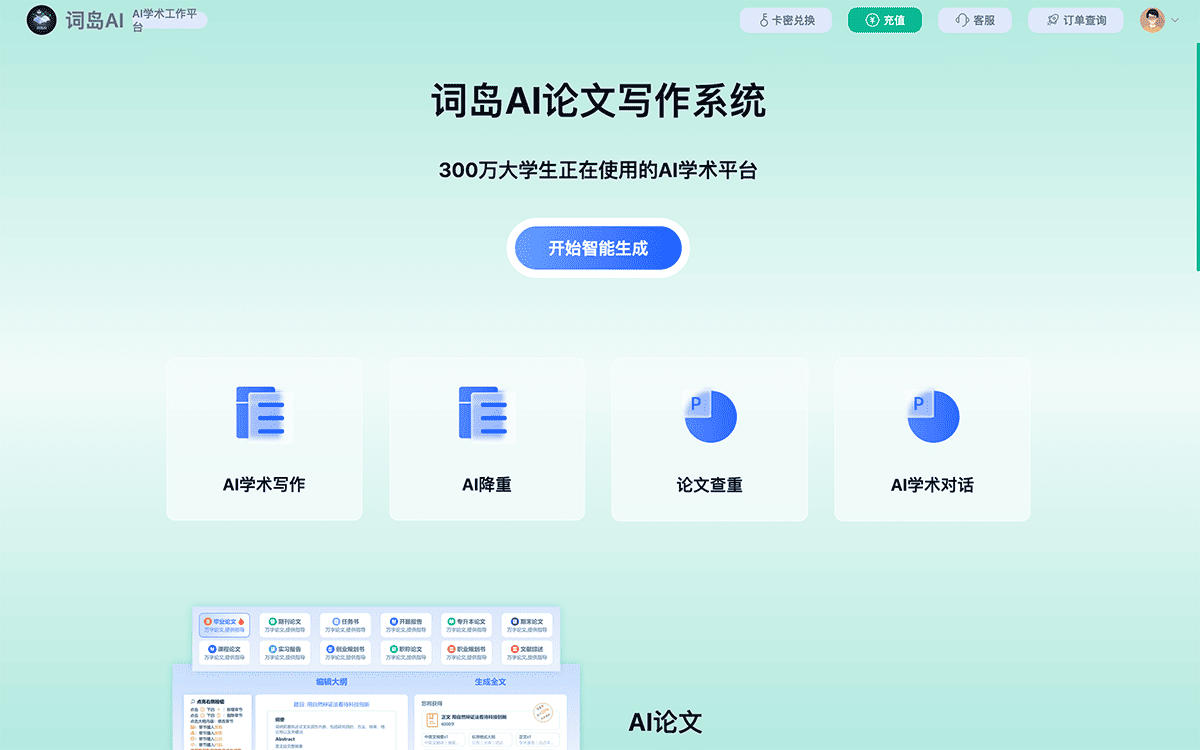
词岛AI论文 词岛AI是一款深耕学术思维重塑与逻辑构建的AI辅助写作助手。我们致力于帮助广大大学生、研究生及教育研究者在论文开题、逻辑大纲、文献综述等关键环节点亮灵感火花。词岛AI集智能逻辑建模、学术语态优化、深度思维导图与高效辅助写作于一身。只需输入您的研究方向或关键词,词岛AI即可为您搭建从选题策略到深度大纲的全流程智能支架,助您从逻辑混乱的泥沼中彻底解脱!
PanoHead PanoHead聚焦面向人工智能创作与应用的在线工具,适合创作者、开发者和需要提升效率的用户使用。,官网域名为github.com。,涉及AI开源项目、AI编程适合需要相关工具与资源的个人用户、创作者或团队使用,可从官网了解最新功能、使用方式和服务条款。
LobeChat 一个开源、可扩展的高性能聊天机器人框架,支持一键部署私有ChatGPT/LLM Web应用程序。它具有快速部署、精致的UI设计、流畅的对话体验、插件支持和自定义插件开发、隐私保护、可自定义的座席角色、自定义域以及角色市场等特征。
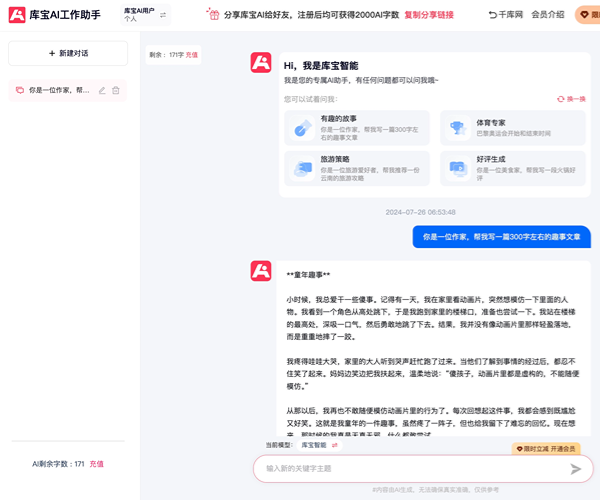
库宝AI工作助手 库宝AI工作助手是千库网推出的多功能AI创作工具,集成了设计、写作、对话、办公和娱乐五大功能模块。通过AI技术提供智能设计、图像处理、语言交流、文案创作和职场辅助等服务,提升工作效率和生活品质。
Video-LLaVA 一个基于深度学习的视频超分辨率(SR)和视频增强(VE)框架,由北京大学元培学院的研究团队开发。该框架旨在提高低分辨率视频的质量和视觉效果,使其更接近高分辨率视频。Video-LLaVA 采用了多尺度融合、残差学习、自适应注意力机制等技术,以提高视频超分辨率和视频增强的性能。 主要特点: 1. 多尺度融合:通过在不同尺度上进行特征融合,提高了模型对细节和全局信息的捕捉能力。 2. 残差学习:引入残差连接,使网络能够更好地学习输入和输出之间的映射关系。 3. 自适应注意力机制:根据输入视频的特点,自动调整注意力权重,使模型能够关注到更重要的区域。 4. 端到端训练:整个框架可以作为一个整体进行端到端训练,简化了模型的训练过程。 5. 支持多种视频格式:Video-LLaVA 支持多种常见的视频格式,如 YUV、RGB 等。
HierVST HierVST 是一种分层自适应零样本语音风格转换模型,它具备以下功能特点: 零样本语音风格转换:HierVST 可以在没有目标说话者语音数据的情况下,将一个新的说话者的语音风格转换为目标风格。这意味着即使没有目标说话者的语音样本,HierVST 也可以生成具有目标风格的语音。 分层自适应结构:HierVST 使用分层自适应生成器,逐步生成音高表示和波形音频,从而实现逐步转换语音的能力。这种结构让模型能够适应新的语音风格,并逐步进行转换。 自监督表示学习:HierVST 仅使用语音数据集进行训练,而无需使用文本转录。它采用了层次变分推断和自监督表示学习的方法,提高了模型在音频表示上的性能。 性能优于其他模型:在零样本语音风格转换场景中,HierVST 的实验结果表明其性能优于其他 VST 模型,如 AutoVC、VoiceMixer、DiffVC、Speech Resynthesis 和 YourTTS。
 DWPose