几何AI
几何AI聚焦面向人工智能创作与应用的在线工具,适合创作者、开发者和需要提升效率的用户使用。,官网域名为jihegeo.com。,涉及AI商品图生成、AI图像工具适合需要相关工具与资源的个人用户、创作者或团队使用,可从官网了解最新功能、使用方式和服务条款。
Let's Enhance 是一个由人工智能驱动的在线AI图片放大工具,可以在不降低质量的情况下改善图像和缩放图像。该工具使用了机器学习的超分辨率技术,在大量真实照片基础上训练的神经网络,依靠其对现实世界中存在的典型物体和纹理的了解,学习恢复细节并保持清晰的线条和轮廓。
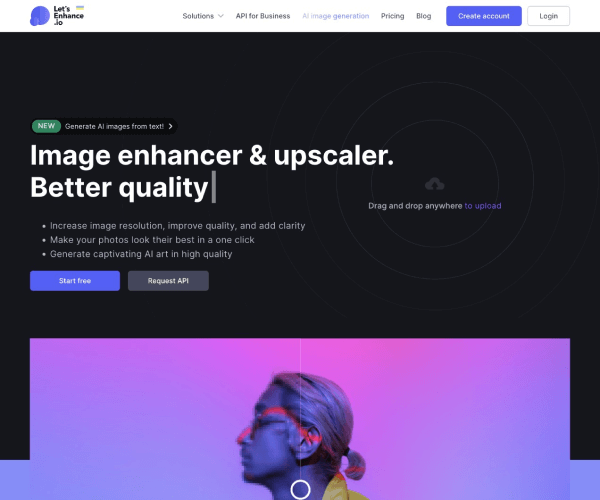 Let’s Enhance
AI在线免费放大图片并保持图像质量 Let’s Enhance 是一个由人工智能驱动的在线 AI图片放大工具 ,可以在不降低质量的情况下改善图像和缩放图像。该工具使用了机器学习的超分辨率技术,在大量真实照片基础上训练的神经网络,依靠其对现实世界中存在的典型物体和纹理的了解,学习恢复细节并保持清晰的线条和轮廓。 除开无损放大功能外,Let’s Enhance 还推出了 AI 图片生成功能,可以帮助用户从文本快速生成高质量的艺术插画和数字资产。 1. 对于创意人员 2. 对于印刷需求 3. 对于AIGC艺术画 Let’s Enhance 针对不同的用户群体和需求,提供了3种不同的产品定价模式: Let’s Enhance 最高可以把图像放大到什么分辨率? 免费用户可以将图片放大到6400万像素,付费用户的上限是256MP像素,商业计划有500MP像素的限制。 如何使用 Let’s Enhance 提高图像清晰度 只需访问 Let’s Enhance 的官网,然后登录/注册你的账号,然后上传你的图片,打开 Light AI 的开关,以改善颜色和照明,点击开始处理即可。 Let’s Enhance 是免费的吗? 每个新用户可获得10个免费点数,你可以测试 Let’s Enhance 的照片增强和图像放大软件,如果你对其结果满意的画,可以购买他们的付费计划。